В этой редакции: кейсы, разбор типичных ошибок ИИ-агентов и порядок запуска.
Типичный запрос к аналитику выглядит так. Менеджер пишет: «посмотри, почему просели продажи в Сибири». Аналитик пишет SQL, собирает выгрузку в Excel и через день-два присылает график, к которому у менеджера тут же появляются новые вопросы. BI-платформы сейчас обещают, что тот же вопрос можно задать системе текстом и получить график через минуту. Мы в ITQuick строим хранилища данных и ИИ-решения для банков и компаний и видим, где агенты в аналитике ускоряют ответ, а где ошибаются в цифрах.
Что ИИ-агент в BI умеет уже сейчас
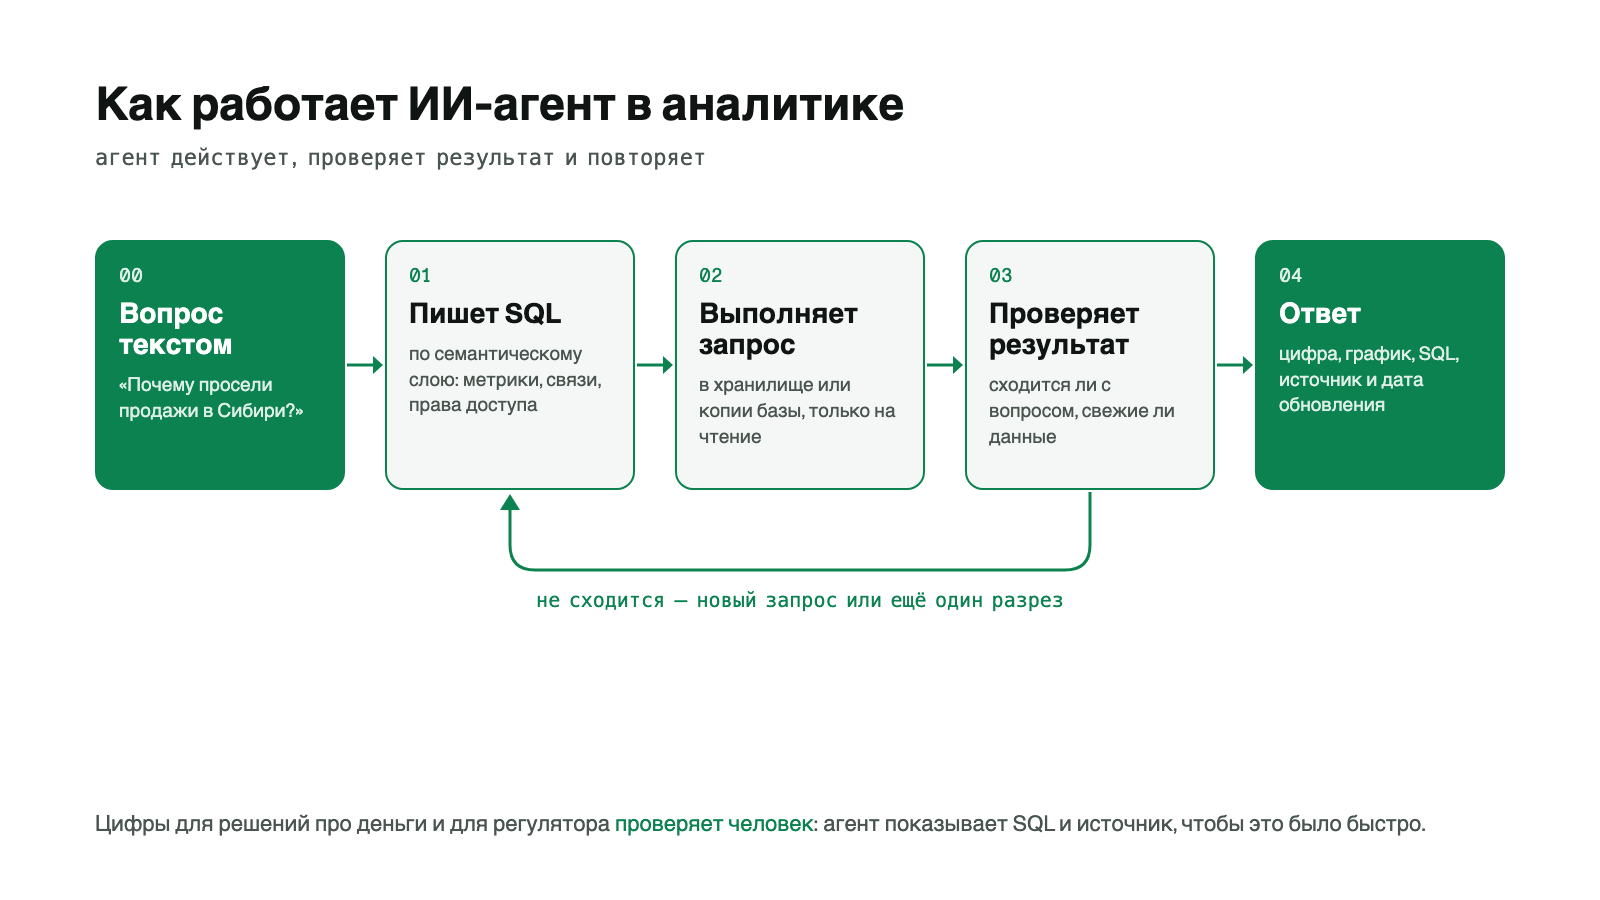
Под ИИ-агентом в аналитике обычно понимают языковую модель с доступом к данным. Она получает вопрос обычным языком, сама пишет запрос к базе, выполняет его, смотрит на результат и решает, что дальше: построить график, переспросить или запросить ещё один разрез. Этим циклом агент и отличается от чат-бота.
Чаще всего агенту отдают вопросы, для которых раньше нужны были фильтры и SQL. Например: «сколько новых клиентов пришло через партнёров в сентябре и какой у них средний чек». Агент сам находит нужные таблицы и пишет запрос.
Ещё ему поручают разбор отклонений. Раньше аналитик перебирал разрезы по регионам, каналам и продуктам вручную. Агент делает это сам и приходит с гипотезой: «Выручка просела в одном регионе, почти целиком за счёт партнёрского канала. Показать разбивку по партнёрам?» Человеку остаётся решить, стоит ли копать дальше.
Задачи попроще тоже есть. По расписанию агент проверяет ключевые показатели и пишет в рабочий чат, если что-то вышло за обычные пределы. Черновик еженедельной сводки с графиками и комментариями он готовит сам, аналитик его правит. Отдельная история — тексты: договоры, обращения клиентов, письма регулятора. Классический BI работает только с таблицами, и письма ЦБ в него не попадают, хотя по ним меняется отчётность. Пример есть ниже, в кейсе про мониторинг законодательства.
Почему без порядка в данных агент ошибается
В пилотах, которые мы видели, первой всплывает проблема с данными. Модель не знает, что в CRM клиент записан как «ООО Ромашка», а в ERP как «Ромашка ООО», и посчитает их двумя компаниями. Ей никто не сказал, что выручку финансовый отдел и отдел продаж считают по разным правилам. Ошибку она при этом не покажет: ответ придёт быстро, с аккуратным графиком и неверной цифрой.
Так было у клиента в нашем проекте Data Fabric MVP. Данные компании лежали в семи системах: CRM, ERP, аналитические базы, Excel-файлы. Отчёт собирали вручную до 4 дней, качество данных было 61% — с дубликатами, пропусками и расхождениями между системами.
За 16 недель мы свели все семь источников в одно хранилище. Конвейер на Apache Airflow и dbt по расписанию загружает, чистит и преобразует данные, отчёты бизнес-пользователи строят сами в Metabase. Время до ответа на аналитический вопрос сократилось с 4 дней до 2 часов, качество данных выросло до 94%, компания сэкономила 44,1 млн ₽. Агента в этом проекте не было, но теперь ему есть с чем работать: одно хранилище вместо семи систем.
Если вы сейчас решаете, нужна ли вам платформа данных вообще, почитайте наш разбор: может, у вас и без неё всё в порядке.
Семантический слой: откуда агент узнаёт смысл цифр
Одних чистых таблиц агенту мало. Ему нужно объяснить, что значат поля и как считаются показатели. Для этого поверх хранилища делают семантический слой с описанием метрик и связей. Например: «активный клиент совершил хотя бы одну операцию за последний квартал», «выручка считается без НДС и возвратов», «регион определяется по адресу доставки».
Звучит как бюрократия, и на старте эту работу хочется пропустить. Мы её не пропускаем. Без семантического слоя два сотрудника зададут агенту один вопрос разными словами и получат разные цифры. После пары таких случаев за цифрами снова идут к аналитику, а агентом перестают пользоваться.
Там же задают, к каким данным агенту вообще можно обращаться. Зарплаты, персональные данные клиентов и банковскую тайну закрывают правами доступа до того, как модель увидит запрос.
Кейс: агенты, которые читают законы
В проекте для Т-Банка задача пришла со стороны регуляторной отчётности. Требования ЦБ к ней менялись быстрее, чем юристы успевали вручную отслеживать изменения законодательства.
Мы модернизировали систему отчётности и поставили ИИ-агентов на мониторинг законодательства. Агенты читают новые нормативные документы и отмечают те, что касаются банка, а юристы разбирают уже отмеченное. Отдельно автоматизировали подготовку налоговых уведомлений. Требования ЦБ к отчётности банк выполняет полностью, автоматизированы три процесса: формирование отчётности, мониторинг законодательства и подготовка налоговых уведомлений.
Новое письмо ЦБ может поменять отчётность раньше, чем это отразится в витрине данных, и агент, который читает документы, замечает это первым.
Что происходит с работой аналитика
Руководители часто спрашивают нас, сократит ли ИИ аналитиков. Иногда сокращает, и делать вид, что нет, странно. В антифроде для одного банка ML-модель взяла на себя первичный разбор подозрительных операций, и команда из 8 аналитиков сократилась до одного. Он разбирает случаи, которые отметила модель. Доля пропущенных мошеннических операций при этом упала с 18% до 2%.
В BI агент чаще меняет состав работы аналитика. Аналитики описывают метрики и следят, чтобы семантический слой не отставал от бизнеса. Они прогоняют агента по контрольным вопросам с заранее известными ответами и разбирают случаи, где он ответил неуверенно или написал слишком тяжёлый запрос. Объяснять бизнесу, что стоит за цифрой и что с ней делать, тоже остаётся им.
Если сводку, которую каждую пятницу собирали вручную, готовит агент, у аналитика освобождается время на отклонения, которые раньше разбирать было некогда. SQL по-прежнему нужен. К нему добавляется умение поставить модели задачу и проверить её ответ.
Где ИИ в аналитике ошибается и как это ловить
Языковые модели иногда выдумывают. В аналитике это выглядит буднично, поэтому такие ошибки легко пропустить:
- Неверное соединение таблиц. Модель связала заказы и платежи не по тому ключу, и суммы удвоились. На графике это выглядит как рост продаж.
- Буквальное понимание вопроса. «Продажи за прошлый месяц» — календарный месяц или последние тридцать дней? Модель выберет сама и не предупредит.
- Придуманное объяснение. Цифру агент посчитал верно, а причину сочинил: «падение связано с сезонностью», хотя данных о сезонности у него не было.
- Устаревшие данные. Ночная загрузка не прошла, и агент посчитал по позавчерашнему срезу, ничего об этом не сказав.
- Тяжёлый запрос к рабочей базе. Агент не знает, сколько строк в таблице транзакций, и запускает полный перебор за всю историю. Если он подключён к рабочей базе, вместе с отчётом встаёт учётная система, в которой работают сотрудники.
Поэтому в проектах мы закладываем несколько правил. Агент работает только с хранилищем или копией базы и только на чтение. В ответе он показывает SQL, по которому считал, и источник данных, а рядом с каждым показателем стоит дата последнего обновления источника. После каждого изменения модели или схемы данных контрольные вопросы прогоняются заново. Цифры для решений про деньги и для регулятора проходят через человека.
Последнее правило легко отменить незаметно: агент какое-то время отвечает правильно, и цифры для правления перестают проверять.
Облако или свой контур
Для банков и компаний с персональными данными этот вопрос решается раньше остальных. Отправка выгрузок с клиентскими данными во внешний API зарубежной модели упирается в требования 152-ФЗ о трансграничной передаче и в правила службы безопасности. Остаются российские облачные модели и локальные, развёрнутые внутри периметра.
Локальная модель хуже флагманских облачных справляется с длинными рассуждениями. Зато данные не покидают контур, и стоимость не растёт с каждым запросом. Чтобы писать SQL по семантическому слою, где описаны все метрики, её часто хватает. Подробнее о локальных моделях — в статье про локальные LLM в компании.
Сколько это занимает
Срок зависит от состояния данных, поэтому приведём сроки наших проектов. Хранилище из семи разрозненных источников с автоматической загрузкой и отчётами для бизнеса мы сделали за 16 недель. ML-модель антифрода, встроенная в поток транзакций банка, заняла 8 недель. Проект с Т-Банком идёт непрерывно, потому что требования регулятора к отчётности продолжают меняться.
Больше всего времени в наших проектах уходило на данные и согласование доступов. Агента ставят поверх готового хранилища, и его срок считают отдельно. Если хранилища нет, планировать стоит от него.
С чего начать
Мы бы предложили такой порядок. Он медленнее, чем подключить ИИ к базе и посмотреть, что выйдет, но так проще добиться, чтобы цифрам агента верили.
- Выберите один процесс. Еженедельный отчёт для правления, разбор отклонений по продажам или мониторинг нормативных документов. Один, и с понятным владельцем.
- Проверьте данные под него. Откуда берутся цифры, сколько систем участвует, совпадают ли справочники. Если отчёт сейчас собирают руками из нескольких выгрузок, начинать придётся с хранилища.
- Опишите метрики. Нужны показатели, которые использует процесс, с формулами и источниками. Получится первая версия семантического слоя.
- Соберите контрольные вопросы. Несколько десятков вопросов, ответы на которые вы знаете. По ним видно, можно ли выпускать агента к людям.
- Решите, где будет работать модель. Зарубежное облако, российский провайдер или свой контур: от этого зависят сроки, бюджет и разговор со службой безопасности.
- Запустите на узкую группу. Первыми агентом пусть пользуются те, кто сам умеет проверить цифру. Расширять круг стоит, когда агент перестал ошибаться на контрольных вопросах.
Если хотите разобрать свою ситуацию — какие данные уже можно отдать агенту, а что сначала придётся привести в порядок, — напишите нам. Такие проекты мы ведём от аудита данных до запуска агентов в работу, в рамках услуги «AI-Native трансформация».